<BG>
Повечето демонстрации от типа „чат с вашия PDF“ спират до един и същ етап: зареждане на файл, векторизиране на сегменти (embeddings), извличане на най-подходящите резултати (top-k) и генериране на отговор. Това е полезно упражнение за обучение, но не така функционират системите за управление на знания в реална среда.
Въпросите от реалния живот са по-сложни. Понякога отговорът се съдържа само във вашите лични документи, друг път – само в интернет, а понякога са необходими и двата източника. Точните термини са също толкова важни, колкото и смисълът. Освен това, ако системата не може да посочи източника на отговора, е трудно да ѝ се гласува доверие.
Създадох LocalMind, за да изследвам тази празнина – не като поредния чатбот-играчка, а като компактна, цялостна система от типа „Agentic RAG“ (система за генериране с разширяване чрез извличане на информация, управлявана от агенти). Тя работи локално по подразбиране, интелигентно насочва заявките към съответните инструменти и прави процеса на извличане на информация измерим и прозрачен.
Проблемът, който исках да реша
Вече бях разработил LocalBot – настолен асистент, който изпълнява модели с отворен код (във формат GGUF) изцяло офлайн, като оптимизира работата според хардуера и поддържа търсене в интернет и прикачване на документи. Този проект доказа, че мощният локален изкуствен интелект е напълно приложим на стандартен компютър.
Липсваше обаче работещ механизъм за извличане на информация (retrieval pipeline) от професионален клас, включващ:
Хибридно търсене (семантично + по ключови думи)
Ясно насочване към инструменти (избор между локални знания и интернет)
Цитиране на източници
Ясен път от идеята през архитектурата и реализацията до оценката на резултатите
Това са ключовите умения, когато преминавате от експерименти към системи, на които хората могат да разчитат.
Какво прави LocalMind
LocalMind е асистент за работа със знания, който поставя поверителността на първо място. Поставяте документи (PDF, DOCX, TXT, Markdown) в папка; системата ги обработва, създава векторен индекс и отговаря на въпроси чрез прост цикъл на работа на агента.
За всеки въпрос системата може:
Да търси само във вашите локални документи
Да търси в публичното интернет пространство (чрез DuckDuckGo, без нужда от API ключ)
Да използва и двата източника
Да отговори без външно търсене, когато това е достатъчно
Отговорите се базират на извлечения контекст и включват препратки към източниците, когато са използвани документи.
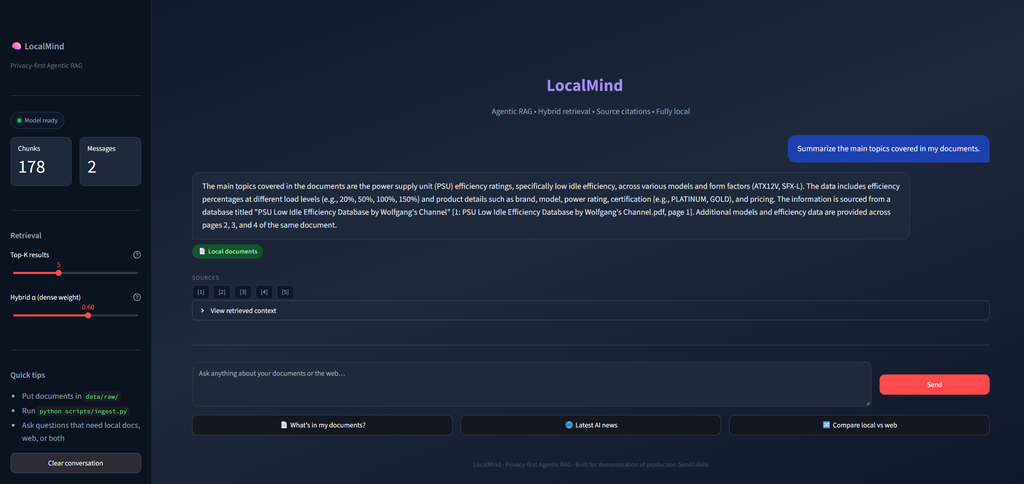
Потребителският интерфейс представлява чат приложение, изградено със Streamlit: решенията за избор на инструменти са видими, източниците са представени като отделни елементи (chips), а извлеченият контекст може да бъде прегледан подробно. Тази прозрачност е търсен ефект. Ако не виждате защо системата е отговорила по определен начин, не можете да я подобрите. Архитектурата на достъпен език
Конвейерът (pipeline) е умишлено опростен и модулен:
Входни данни (Ingestion)
Зареждане на документи → разделяне на припокриващи се сегменти с метаданни (файл, страница) → генериране на ембединги (векторни представяния) чрез SentenceTransformers → съхранение в Chroma.
Извличане (Retrieval)
Хибридното търсене съчетава:
Плътни вектори (смисъл)
BM25 (точни ключови думи)
Резултатите се нормализират и обединяват с тегловен коефициент α, който може да се настройва. Чистото векторно търсене често пропуска кодове за грешки, имена на продукти или правни термини. Чистото търсене по ключови думи пропуска перифрази. Хибридният подход е прагматична „златна среда“.
Агент (Agent)
Лек маршрутизатор (router) решава кой инструмент да извика, изпълнява го, сглобява контекста и след това генерира окончателния отговор с инструкции за цитиране. Това не е тежка многоагентна рамка (framework). Тя е достатъчна, за да демонстрира динамична стратегия за извличане, без излишна сложност.
Извеждане (Inference)
Локални GGUF модели чрез llama-cpp-python, с хардуерно разпознаване, адаптирано от LocalBot (CUDA, Metal, ROCm или CPU). Не се изисква облачна инфраструктура за основната функционалност.
Ключови дизайнерски решения
Приоритет на локалната работа (Local-first).
Чувствителните документи не трябва да напускат машината. LocalMind извършва генерирането на ембединги и отговори локално. Уеб търсенето е опционално и изисква изрично действие.
Хибридно извличане вместо чисто векторно.
Това е едно от първите подобрения, които придават на RAG системата усещане за „истински“ продукт. Освен това е лесно за обяснение и за тестване чрез промяна на параметри (ablation study): променяте α и измервате резултата.
Агентът като маршрутизатор, а не като самоцелно зрелище.
Стойността не е в „агенти заради самите агенти“. Стойността е в избора на правилния източник на знания за всяка заявка и в честното признаване на неуспех, когато наличните доказателства са слаби.
Структурата на проекта като сигнал.
Третирах LocalMind като малък продукт: ясни модули, конфигурация чрез .env, разбивка на задачите, архитектурни бележки и план за развитие (roadmap). Тази дисциплина е също толкова важна, колкото и самото извикване на модела.
Какво бих направил след това
Една сериозна RAG система се нуждае от количествени показатели, а не само от демонстрации. Следващи стъпки в моя списък:
Златен набор за оценка и основни показатели (вярност, релевантност, прецизност на контекста)
Пренареждане и по-добри стратегии за разделяне на фрагменти
Качване на документи от потребителския интерфейс
Тънък слой FastAPI за интеграция
Наблюдаемост: латентност, качество на извличане, обратна връзка от потребителите
Това са същите стъпки, които предприемате, когато премествате PoC към производство: измерване, затягане на извличането, предоставяне на API, наблюдение на поведението.
Защо създадох това
Грижа ме е за практичния генеративен изкуствен интелект — системи, които зачитат границите на данните, правят решенията за извличане видими и могат да бъдат обосновани от инженери и заинтересовани страни.
LocalBot показа, че локалният извод може да усети качеството на продукта.
LocalMind показва как този извод се превръща в система от знания: приемане, извличане, маршрутизиране, цитиране, подобряване.
Ако работите върху RAG, агенти или локални инструменти за LLM, хранилището е отворено и архитектурата е умишлено четлива. Обратната връзка и критиката са добре дошли.
<EN>
Most “chat with your PDF” demos stop at the same place: load a file, embed chunks, retrieve top-k, generate an answer. That is a useful learning exercise. It is not how real knowledge systems behave.
Real questions are messier. Sometimes the answer is only in your private documents. Sometimes it is only on the web. Sometimes you need both. Exact terms matter as much as meaning. And if the system cannot say where an answer came from, it is hard to trust.
I built LocalMind to explore that gap — not as another toy chatbot, but as a small, end-to-end Agentic RAG system that stays local by default, routes tools intelligently, and keeps retrieval measurable and transparent.
The problem I wanted to solve
I had already built LocalBot, a desktop assistant that runs open-source GGUF models fully offline, with hardware-aware inference, web search, and document attachment. It proved that capable local AI is practical on a normal machine.
What it did not yet demonstrate was a production-style retrieval pipeline:
- Hybrid search (semantic + keyword)
- Explicit tool routing (local knowledge vs web)
- Source citations
- A clear path from idea → architecture → implementation → evaluation
Those are the skills that matter when you move from experiments to systems people can rely on.
What LocalMind does
LocalMind is a privacy-first knowledge assistant. You put documents in a folder (PDF, DOCX, TXT, Markdown). The system ingests them, builds a vector index, and answers questions through a simple agent loop.
For each question it can:
- Search only your local documents
- Search the public web (DuckDuckGo, no API key)
- Use both
- Answer without external retrieval when that is enough
Answers are grounded in retrieved context and include source references when documents are used.
The UI is a Streamlit chat app: tool decisions are visible, sources are shown as chips, and retrieved context can be inspected. That transparency is intentional. If you cannot see why the system answered the way it did, you cannot improve it.
Architecture in plain terms
The pipeline is deliberately simple and modular:
Ingestion
Load documents → split into overlapping chunks with metadata (file, page) → embed with SentenceTransformers → store in Chroma.
Retrieval
Hybrid search combines:
- Dense vectors (meaning)
- BM25 (exact keywords)
Scores are normalized and fused with a weight α you can tune. Pure vector search often misses error codes, product names, or legal phrases. Pure keyword search misses paraphrases. Hybrid is a pragmatic middle ground.
Agent
A lightweight router decides which tool to call, runs it, assembles context, then generates the final answer with citation instructions. This is not a heavy multi-agent framework. It is enough to show dynamic retrieval strategy without unnecessary complexity.
Inference
Local GGUF models via llama-cpp-python, with hardware detection adapted from LocalBot (CUDA, Metal, ROCm, or CPU). No cloud requirement for core use.
Design choices that mattered
Local-first.
Sensitive documents should not need to leave the machine. LocalMind runs embeddings and generation locally. Web search is optional and explicit.
Hybrid retrieval over pure vectors.
This is one of the first upgrades that makes RAG feel “real.” It is also easy to explain and easy to ablate: change α and measure.
Agent as a router, not a spectacle.
The value is not “agents for agents’ sake.” The value is choosing the right knowledge source per query and failing honestly when evidence is weak.
Project structure as a signal.
I treated LocalMind like a small product: clear modules, config via .env, a work breakdown, architecture notes, and a roadmap. That discipline matters as much as the model call.
What I would do next
A serious RAG system needs numbers, not only demos. Next steps on my list:
- A golden evaluation set and basic metrics (faithfulness, relevance, context precision)
- A reranker and better chunking strategies
- Document upload from the UI
- A thin FastAPI layer for integration
- Observability: latency, retrieval quality, user feedback
Those are the same steps you take when moving a PoC toward production: measure, tighten retrieval, expose an API, monitor behavior.
Why I built this
I care about practical Generative AI — systems that respect data boundaries, make retrieval decisions visible, and can be reasoned about by engineers and stakeholders.
LocalBot showed that local inference can feel product-quality.
LocalMind shows how that inference becomes a knowledge system: ingest, retrieve, route, cite, improve.
If you work on RAG, agents, or local LLM tooling, the repo is open and the architecture is intentionally readable. Feedback and critique are welcome.
Ivan Dambulov — building practical AI tools with a focus on local systems, RAG, and clear engineering.
Leave a Reply